Resumen
Search Console solo muestra los últimos 16 meses: lo que pasa de ahí se pierde. Para conservar el histórico hay dos caminos hacia BigQuery. La exportación masiva nativa manda cada día las tablas searchdata_site_impression y searchdata_url_impression, pero exige un proyecto con facturación y solo guarda datos desde el día en que la activas. La API de Search Analytics sí recupera los 16 meses anteriores, aunque pierde el tráfico de búsquedas anonimizadas cuando cruzas página con consulta. Para un sitio mediano, el costo suele quedarse dentro de la capa gratuita de BigQuery (10 GiB de almacenamiento y 1 TiB de consultas al mes).
El problema: 16 meses y luego nada
Cada día, Search Console borra el día más viejo de esos 16 meses. Comparar tu temporada alta contra la de hace dos años ya no se puede. Y el panel enseña como máximo 1.000 filas por tabla.
Me di cuenta de lo caro que sale esto con una tienda de muebles en Lima. Su propiedad de Search Console tiene datos desde el 7 de septiembre de 2026, nada antes. Cuando armé su análisis de temporadas (Cyber Wow, Navidad, Día de la Madre) no tenía ni un año propio contra el cual comparar y tuve que tirar de Google Trends. Desde entonces, en cada cliente nuevo pongo a guardar el histórico el primer día.
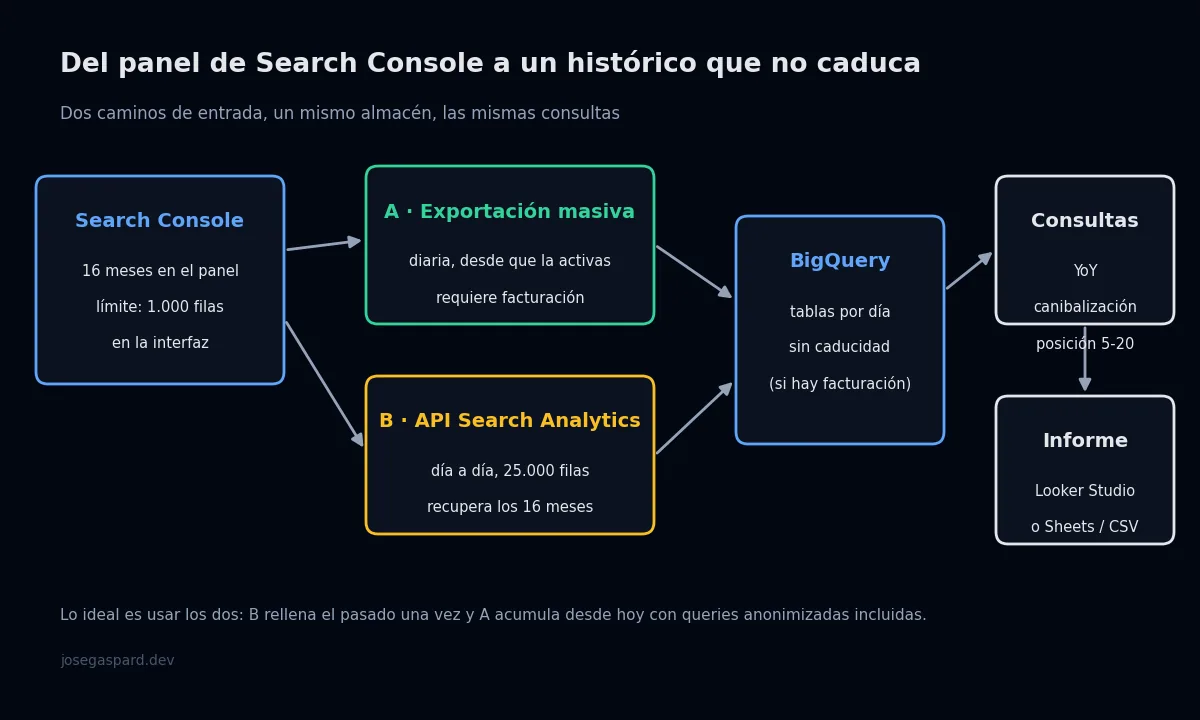
Opción A: la exportación masiva nativa
Se activa desde Configuración de Search Console, en «Exportación masiva de datos». Antes necesitas tres cosas en Google Cloud:
- Un proyecto con la API de BigQuery activada y una cuenta de facturación vinculada. Sin facturación no deja seguir.
- Dar a la cuenta
search-console-data-export@system.gserviceaccount.comlos roles «BigQuery Job User» y «BigQuery Data Editor» en ese proyecto. - Elegir el nombre del dataset. Por defecto es
searchconsole; si vas a mandar varias propiedades al mismo proyecto, cada una necesita su propio dataset.
La primera carga llega hasta 48 horas después de configurarla. De ahí en adelante, todos los días.
Su ventaja frente a la API: conserva las búsquedas anonimizadas, con la consulta vacía y is_anonymized_query = true, así que los totales cuadran con el panel. Su gran limitación es que no trae nada del pasado. Para lo anterior, Google remite a la API.
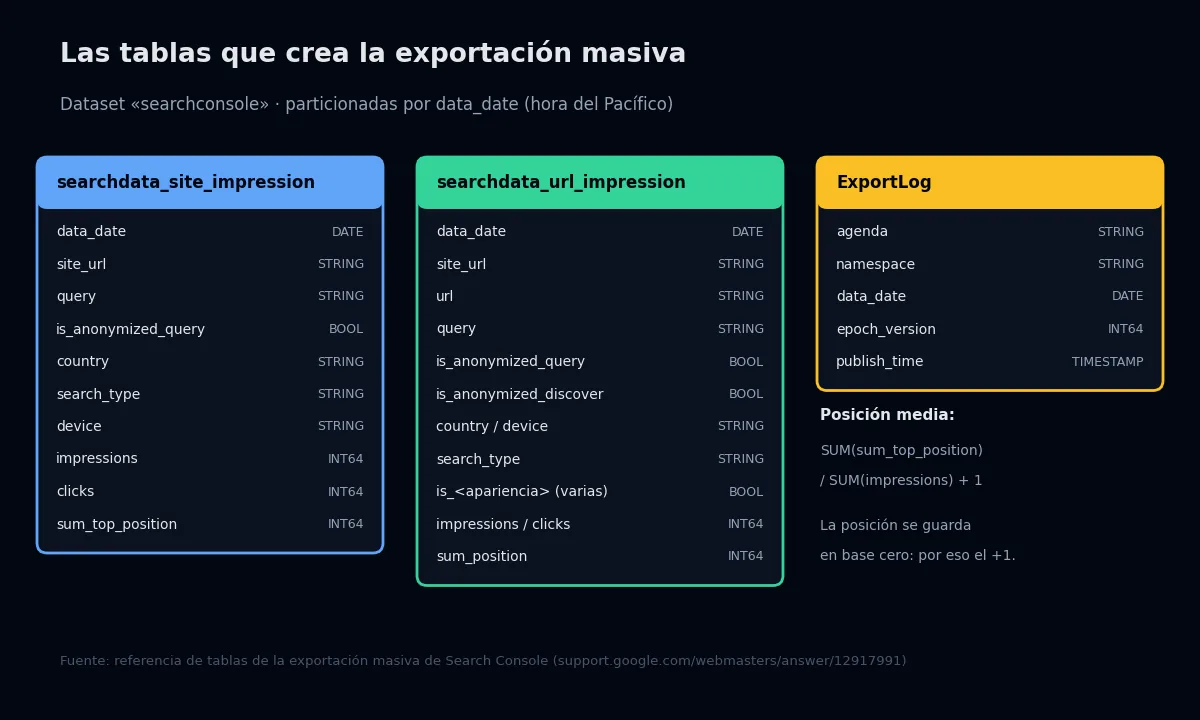
La posición se guarda sumada y en base cero. La media se calcula como SUM(sum_top_position) / SUM(impressions) + 1 (o sum_position en la tabla de URLs). Si te sale todo una posición mejor de lo que ves en el panel, te faltó el +1.
Opción B: extraer con la API (y la trampa de lo anonimizado)
En nuestro proyecto de Google Cloud no había facturación activa, así que la exportación masiva quedó bloqueada. Lo resolvimos con un script que llama a la API de Search Analytics con una cuenta de servicio y carga el resultado en BigQuery con bq load --replace. Lo dejamos programado en el servidor para que corra cada mañana. Así llenamos 16 meses de varias propiedades de una sola vez.
Aprendimos dos cosas a golpes.
Pide día por día. Con rangos de un mes la API devuelve menos filas: medimos unas 850 filas por día de consulta × página pidiendo el mes entero, contra unas 1.960 pidiendo un solo día. Dentro de cada día hay que paginar con startRow de 25.000 en 25.000 hasta que venga vacío.
Cuando cruzas página con consulta, país o dispositivo, la API omite lo anonimizado. En un e-commerce B2B de México, el 15 de agosto de 2026 la propiedad sumaba 124 clics. Pidiendo página × consulta salían 42. En 16 meses, a la tabla consulta × página le faltaba el 63,4 % de los clics de ese sitio. Mi primer informe sacó los totales de una tabla cruzada (página × dispositivo × país) y reportó 4.122 clics de julio a octubre, cuando la API daba 11.816. Ahora guardamos los totales aparte, en una tabla solo por fecha; la de dispositivo × país cuadra con ella al 0,0 %. La tabla consulta × página queda para análisis de keywords, nunca para sumar.
Ojo con el sandbox. BigQuery sin facturación (sandbox) caduca tablas, vistas y particiones a los 60 días. En la primera carga particioné por fecha y el sandbox borró en el acto todo lo anterior a agosto de 2026. Recargué sin partición, pero aun así cada tabla caduca 60 días después de cargarse. Para guardar de verdad, activa la facturación.
Tres consultas SQL que uso de verdad
Están escritas para las tablas de la exportación masiva. Cambia mi-proyecto por tu proyecto. Filtra siempre por data_date: las tablas están particionadas por fecha y así BigQuery solo lee los días que pides.
1. Año contra año por mes
WITH m AS (
  SELECT DATE_TRUNC(data_date, MONTH) AS mes,
         SUM(clicks) AS clics, SUM(impressions) AS impresiones
  FROM `mi-proyecto.searchconsole.searchdata_site_impression`
  WHERE search_type = 'WEB'
  GROUP BY mes)
SELECT a.mes, a.clics, b.clics AS clics_hace_un_anio,
  ROUND(SAFE_DIVIDE(a.clics - b.clics, b.clics) * 100, 1) AS var_pct
FROM m a
LEFT JOIN m b ON b.mes = DATE_SUB(a.mes, INTERVAL 12 MONTH)
ORDER BY a.mes;
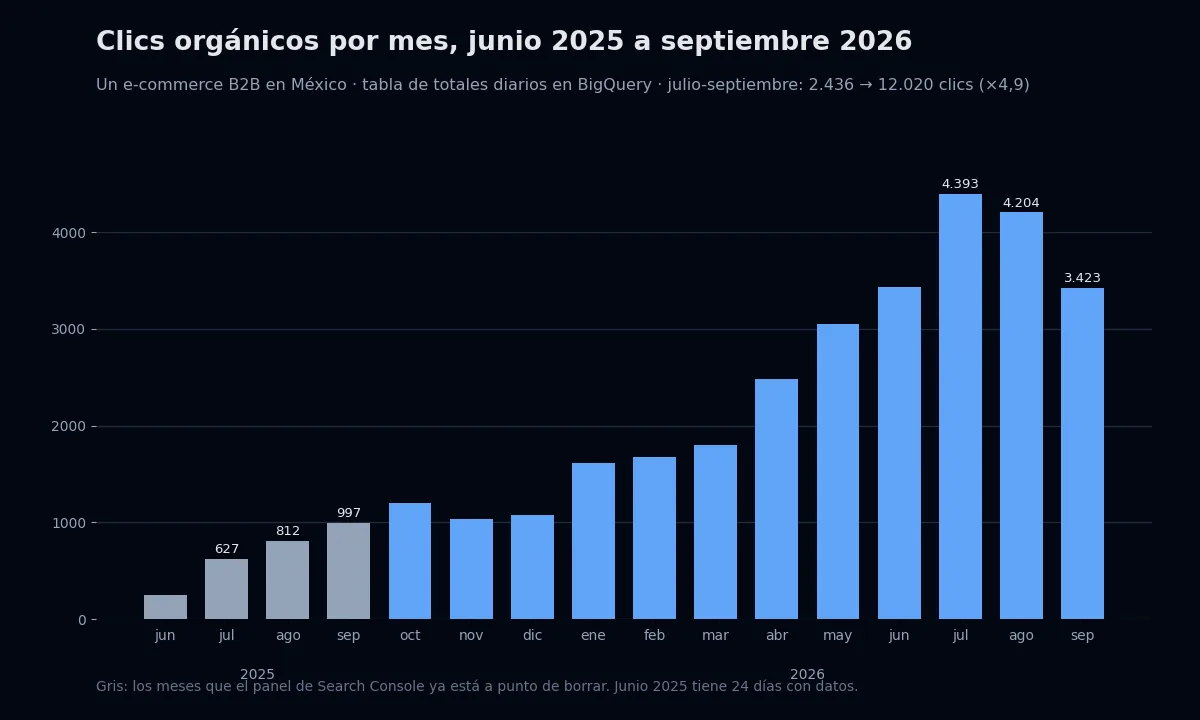
Con esta misma lógica (sobre la tabla de totales que cargamos por API) sale la gráfica de abajo. Julio a septiembre de 2025 sumó 2.436 clics y el mismo trimestre de 2026, 12.020. En el panel, esos meses de 2025 están a punto de desaparecer.
2. Canibalización entre URLs
Busca consultas sin marca donde dos o más URLs se reparten las impresiones (cada una con al menos el 10 % y 20 impresiones en 90 días).
WITH q AS (
  SELECT query, url, SUM(impressions) AS impr, SUM(clicks) AS clics,
         SUM(sum_position) / SUM(impressions) + 1 AS posicion
  FROM `mi-proyecto.searchconsole.searchdata_url_impression`
  WHERE search_type = 'WEB'
    AND data_date >= DATE_SUB(CURRENT_DATE(), INTERVAL 90 DAY)
    AND NOT is_anonymized_query
    AND NOT REGEXP_CONTAINS(LOWER(query), r'tu marca')
  GROUP BY query, url),
t AS (SELECT *, SUM(impr) OVER (PARTITION BY query) AS impr_query FROM q)
SELECT query, COUNT(*) AS urls, ANY_VALUE(impr_query) AS impresiones,
  STRING_AGG(FORMAT('%s (pos %.1f, %d impr)', url, posicion, impr),
             ' | ' ORDER BY impr DESC) AS detalle
FROM t
WHERE impr >= 20 AND impr >= 0.10 * impr_query
GROUP BY query
HAVING COUNT(*) >= 2
ORDER BY impresiones DESC;
En el mismo e-commerce B2B devolvió 442 consultas. No todas son problema: revísalas a mano antes de fusionar nada, y limpia primero las URLs con fragmentos # usando REGEXP_REPLACE, porque si no cuentan como páginas distintas.
3. Keywords en posición 5-20
SELECT query, url, SUM(impressions) AS impr, SUM(clicks) AS clics,
  ROUND(SUM(sum_position) / SUM(impressions) + 1, 1) AS posicion
FROM `mi-proyecto.searchconsole.searchdata_url_impression`
WHERE search_type = 'WEB'
  AND data_date >= DATE_SUB(CURRENT_DATE(), INTERVAL 90 DAY)
  AND NOT is_anonymized_query
GROUP BY query, url
HAVING posicion BETWEEN 5 AND 20 AND impr >= 100
ORDER BY impr DESC
LIMIT 200;
Son páginas que Google ya considera relevantes pero que casi nadie ve. En ese sitio salieron 370 pares consulta-URL sin marca con 208.444 impresiones en 90 días. Es la primera lista que reviso cada mes, antes que cualquier herramienta de pago.
Cuánto cuesta
Revisé la página de precios de Google Cloud el 7 de octubre de 2026:
| Concepto | Capa gratuita | Después |
|---|---|---|
| Almacenamiento lógico activo | 10 GiB al mes | US$0.000031507 por GiB-hora (unos US$0.023 por GiB al mes) |
| Consultas bajo demanda | 1 TiB procesado al mes | US$6.25 por TiB |
Carga por lotes (bq load) | Gratis con el grupo de slots compartido | |
| Sandbox (sin facturación) | 10 GiB de por vida, 1 TiB al mes, todo caduca a los 60 días | |
Para ponerlo en escala: 16 meses de tres sitios ocupan unos 134 MB en las tablas de Search Console. La más grande, consulta × página, tiene 476.923 filas y pesa 78,9 MB. Estamos muy lejos de los 10 GiB. La exportación masiva pesa más (trae país, dispositivo y lo anonimizado), pero un sitio mediano tarda años en salir de la capa gratuita. Lo que sí puede costar es una consulta mal escrita sobre un sitio grande sin filtro de fechas. Antes de correrla, mira cuántos bytes leerá.
Si prefieres que lo monte yo, es parte de mi trabajo de posicionamiento SEO. Si quieres hacerlo tú, mi guía de SEO técnico y la lista de herramientas SEO gratuitas son buen complemento.
Preguntas frecuentes
¿La exportación masiva de Search Console trae los datos de meses anteriores?
No. Solo exporta desde el día en que la configuras, y la primera carga llega hasta 48 horas después. Para el pasado usa la API, que llega a 16 meses.
¿Puedo usar la exportación masiva con BigQuery sandbox?
No, Google pide un proyecto con facturación. En sandbox puedes cargar datos por API, pero las tablas caducan a los 60 días.
¿Por qué no me cuadran los clics de BigQuery con los del panel?
Casi siempre es lo anonimizado: si cruzaste página con consulta, país o dispositivo en la API, ese tráfico falta. Saca los totales de una petición solo por fecha.
¿Cuánto cuesta guardar Search Console en BigQuery?
Para la mayoría de los sitios, nada. La capa gratuita incluye 10 GiB de almacenamiento y 1 TiB de consultas al mes, y tres sitios con 16 meses ocupan unos 134 MB. Pasado eso, las consultas cuestan US$6.25 por TiB.
¿Cómo calculo la posición media en las tablas exportadas?
Suma la columna de posición y divídela entre las impresiones, luego suma 1: SUM(sum_top_position) / SUM(impressions) + 1. La posición se guarda en base cero, por eso hace falta el +1.